pdlc-skills を実際のプロジェクトで回してみる:三つの機能を並行させてリリースまで
目次
前七回は仕組みの話でした。今回は実際のプロジェクトに戻り、導入したあとに初めてぶつかる六つの問いに答えます。機能をどう分けるか、人と AI でどう分担するか、ループは実際どう回るのか、どれくらい時間がかかるのか、どれだけの量が出るのか、品質は何で支えるのか。対象は私が自分で使っているコンソール系のプロジェクトです。三つの機能を pdlc 付属のループエンジンに並行で渡し、88 分で全部がレビューの終端状態に到達しました。そのあと品質ゲートを埋めてからリリースし、二台のマシンに配備しています。機械が出した数字はイベントログと git から取ったものです。人がかけた時間は見積もりなので、その箇所では明記します。
この回の出発点
このプロジェクトは 8 月下旬に /pdlc-bootstrap で骨組みを作り、五日で最小構成からコンソールの第三期まで進めたあと、三週間ほど放置していました。再開してまずやったことが二つあります。/pdlc-test-setup でユニットテスト・カバレッジ・lint の三つのコマンドを test-commands.yml に書き込むこと。三つとも実際に走って初めてカウントされます。もう一つは、古い状態ファイルを現行フォーマットに移行することです。この二つを飛ばすと、そのあとの各ステップの「チェック通過」には何の根拠もなくなります。E2E は前日に入れたばかりで、登録済みのコアフロー 45 本それぞれにテストがついている状態でした。つまりこの回の出発点は、ユニットテスト 421 本、E2E 52 ケース、カバレッジ 89.6% です。
機能をどう分けたか
今回やることは三つです。レビューする側を別のマシンに置けるようにすること、通知をタスクの発生元で絞れるようにすること、ベンチマークの実行にレビュー用のフラグを二つ足すこと。以下ではそれぞれ、ノード間レビュー、発生元フィルタ、ベンチマークのフラグと呼びます。どれも大きくはありません。だからこそループを試すのにちょうどいい題材でした。分け方は三つの原則に従っています。
一つめ、コードの依存関係で「鎖」か「独立」かに切ること。ベンチマークのフラグは、ノード間レビューが作るリモート投入と結果の回収を使います。この二つは鎖なので、後ろは前が収束してから走り出します。発生元フィルタはどちらにも触らないので、すぐに走り出せます。
二つめ、一つの機能の大きさは「三ステップで終わる」を基準にすること。三ステップとは TDD・実装・レビューです。今回の三機能はいずれも差分 800〜1500 行に収まりました。
三つめ、並行させる機能は同じファイルを触らないこと。これは守れませんでした。三つとも同じレシート集約モジュールを変更する必要があり、ツケはマージのときに来ます。衝突を一つずつ解消して、十分ほど余計にかかりました。
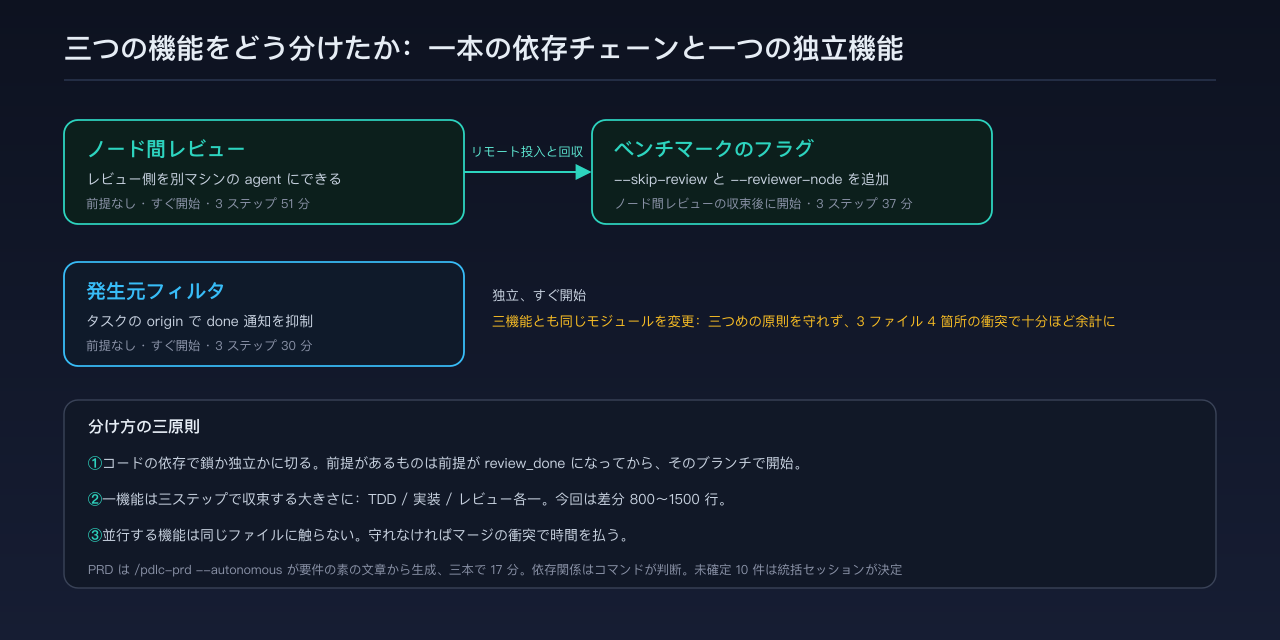
PRD は /pdlc-prd --autonomous で生成しました。入力は要件の素の文章が数段落、三本あわせて 17 分です。依存関係はコマンドが素の文章から自分で書き出しました。それぞれの PRD の末尾には未確定の問いが残っており、三本で計十件。統括セッションが一件ずつ判断して書き戻しています。回収クエリが失敗したときにどのイベントとして記録するか、指定されたマシンが設定に登録されていないときにどのエラーを返すか、といった内容です。ここを決めずに走らせると、三つのプロセスがそれぞれ違う解釈で書きます。
誰が何をやるか
登場するのは四者です。私、常時開いている統括セッション、ステップが終わると終了するサブプロセス、そして外側のスクリプト。統括セッションも AI ですが、機能コードは書きません。調整と再確認だけを担当します。
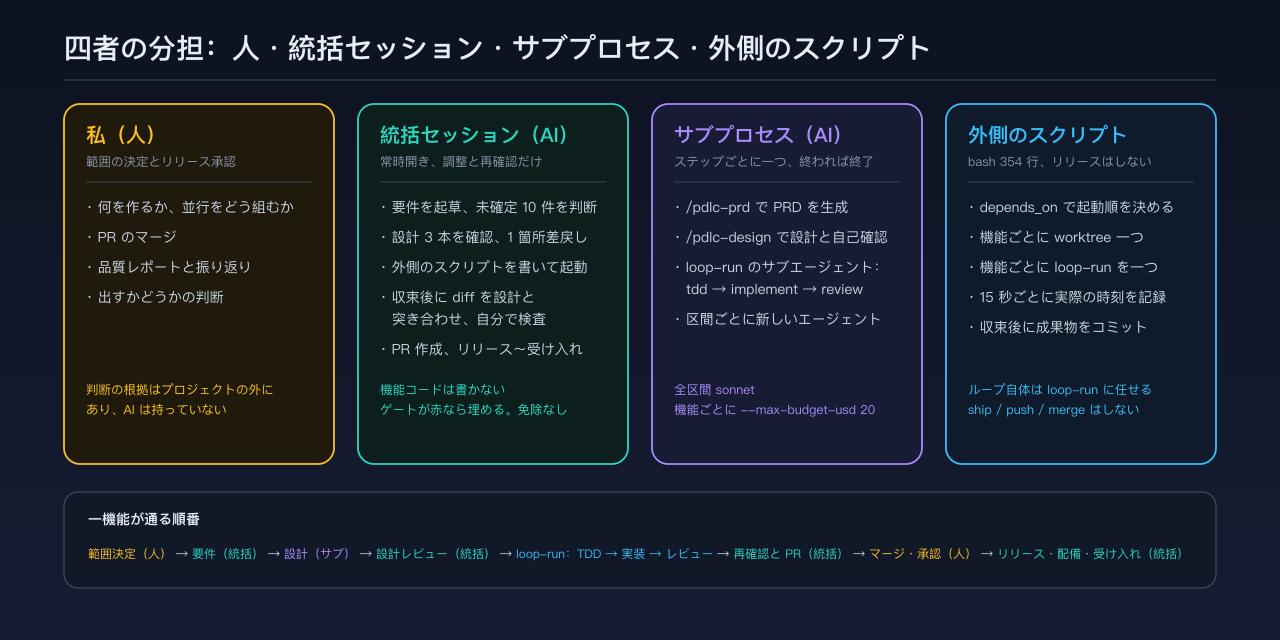
何を作るか、並行をどう組むかは私が決めます。要件はまず統括セッションが素の文章を起草し、それをコマンドが PRD に変換し、未確定の問いは統括セッションが判断します。
設計は機能ごとに新しいプロセスを立てて /pdlc-design --autonomous を走らせました。三本並行で 12 分あまり、統括セッションが 15 分かけてレビューし、一箇所を差し戻しています。ベンチマークのフラグの設計で、ノード間の部分が「依存がまだできていないので、リクエストは拒否して記録だけ残す」と書かれていました。しかしこの機能はノード間レビューの後ろから切ったブランチに乗っているので、実装される時点でリモート投入は存在します。ここは本当に呼びにいくべきです。
TDD・実装・レビューの三段はループに任せ、誰も見ていません。モデルは全区間 sonnet、機能ごとに一周分の予算上限をつけています。機能が収束したら、統括セッションが差分を設計と突き合わせ、三つのチェックを自分で走らせてから PR を作ります。リリース・配備・受け入れのコマンドも統括セッションの担当です。私がやるのは PR のマージ、品質レポートと振り返りを読むこと、そして出すかどうかの判断です。人が必要な箇所はちょうど二つ、何を作るかを決めるところと、出すかどうかを決めるところだけでした。
ループをどう回すか
pdlc 付属のループエンジンが /pdlc-loop-run です。現在の段階から始めて、TDD・実装・レビューの各区間を毎回新しいサブエージェントに渡し、一区間終わるごとに状態ファイルを読み、決められた対応表を見て次のステップを決めます。review_done で停止し、自分でリリースすることは決してありません。ここは二層構造です。外側は機能ごとに一プロセス、そのプロセスの中で loop-run が区間ごとにサブエージェントを立てます。ガードレールはステップ上限 4、一ステップでも失敗したら停止、状態が進んでいなければ停止の三つです。
loop-run が見るのは一度に一機能だけです。複数を並行させるには外側にスケジューリング層が要ります。今回はそれが 350 行あまりの bash スクリプトでした。各機能の状態ファイルにある depends_on を読んで順番を決め、前提がないものはすぐに走らせ、前提があるものは前提が収束するのを待ってそのブランチから切ります。機能ごとに git worktree を一つ与えて、それぞれの場所で走らせます。機能ごとにプロセスは一つです。
claude -p --model sonnet --max-budget-usd 20 --permission-mode acceptEdits \
  "/pdlc-loop-run $fid --max-steps 4 --autonomous"
プロセスが終了したら、スクリプトが状態ファイルを読んで成果物をコミットします。さらに 15 秒ごとに状態ファイルを見て、段階が切り替わった実際の時刻を記録しています。状態ファイルの中でモデル自身が書いたタイムスタンプは信用できないからです。
走り出しの時点では、ノード間レビューと発生元フィルタが同時に動き始めました。いちばん速かったのは発生元フィルタで、三ステップ 30 分で収束。ノード間レビューは 51 分かかり、収束した 13 秒後にスクリプトがそのブランチからベンチマークのフラグを立ち上げ、さらに 37 分走りました。三機能とも 88 分で review_done に到達し、どれも 3 ステップしか使っていません。レート制限にも当たらず、予算を使い切ったステップもなく、途中で一度も止まりませんでした。
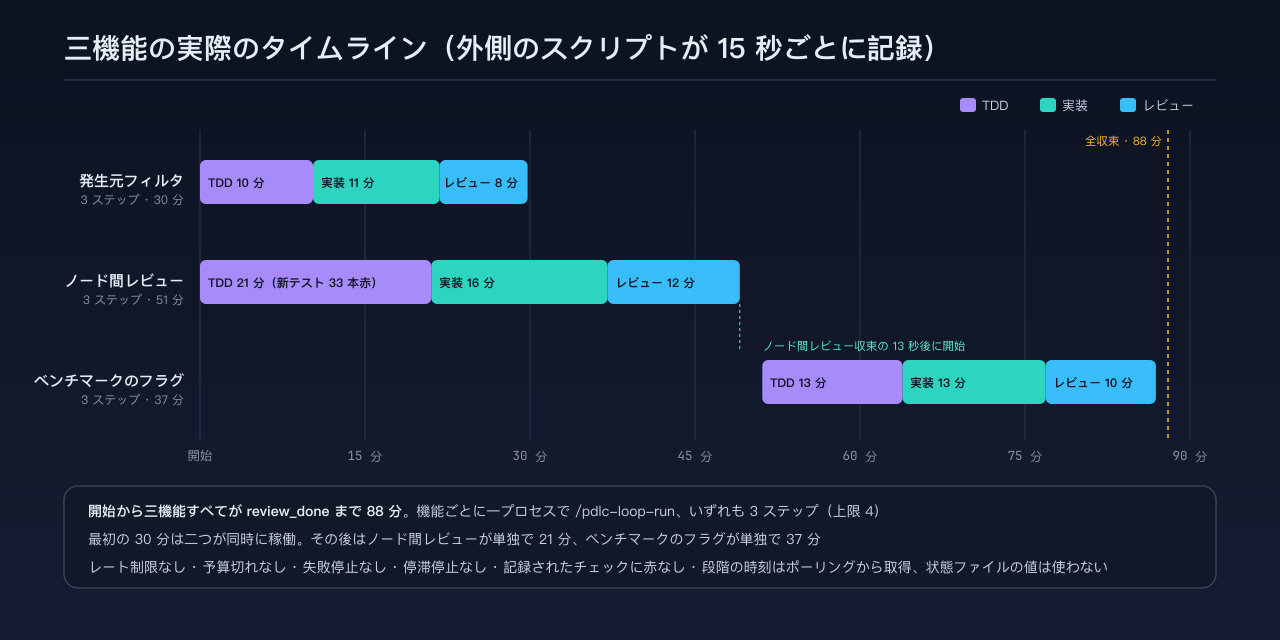
一つ記録しておく価値があることがあります。三つの機能が状態ファイルに書いた段階名は揃っていませんでした。収束時に二つが review_done、一つが review。さらに一つは TDD のステップを tdd_done と書いています。字面どおりに読めば _done は完了なので、ループが TDD の時点で収束とみなして止まる可能性もありました。loop-run はこの書き方に騙されず、通常どおり実装のステップを立てています。ただこれは、「前に進んだかどうか」を段階名だけで判断してはいけない、次ステップのフィールドが変わったかまで見る必要がある、ということです。
かかった時間と出てきた量
機能ごとのステップ数、機械が使った時間、差分の行数は次のとおりです。テストの括弧内は新規ケース数です。
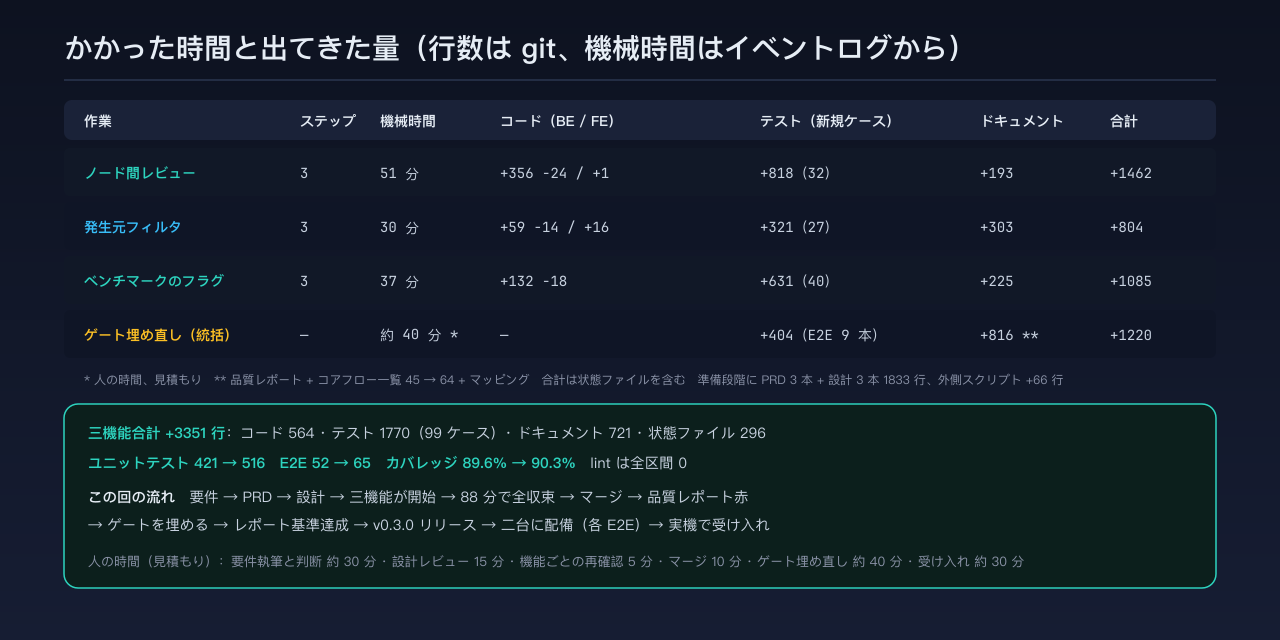
三機能の合計は 3351 行の追加で、うちテストが 1770 行。機能コードそのものの三倍ほどです。PRD と設計は別勘定で 1833 行。ユニットテストは 421 本から 516 本、E2E は 52 ケースから 65 ケース、カバレッジは 89.6% から 90.3% になりました。
全体の流れはこうです。要件を起草し、PRD を生成し、設計をレビューし、三機能を走らせ、88 分後に全部収束、ブランチをマージして品質レポートを実行、赤。足りないところを埋めてレポートが基準を満たし、v0.3.0 をリリース、二台に配備して、実機で受け入れ。人がかけた時間は見積もりで、合計二時間半ほど。内訳は要件を書くこと、設計をレビューすること、機能が収束するたびに再確認すること、マージ、そしてゲートの埋め直しです。
品質は何で支えたか
誰も見ていない状態で品質を支えるのは、四つの層です。
一つめは、各ステップの客観的なチェックです。どのステップでどのコマンドを走らせるかは test-commands.yml に書いてあり、見るのは終了コードだけ。モデルが「確認しました」と言っても通りません。TDD のステップで検証するのは、新しく書いたテストが本当に落ちることです。実装とレビューの二ステップではユニットテスト・カバレッジ・lint の通過を検証し、三機能のうち二つは E2E も走らせています。カバレッジ 85% のしきい値はコマンドの引数に直接書いてあります。pre-commit は lint、pre-push はユニットテストを実行し、どちらも同じファイルのコマンドを使います。今回は三機能 × 三ステップで、記録されたチェック項目に赤は一つもありませんでした。
二つめは、収束後の再確認です。統括セッションが機能ごとに差分を設計と突き合わせ、三つのチェックを自分で走らせてから PR を作ります。今回は三機能とも差分が設計どおりで、人手による修正は前述の設計レビューの一箇所だけでした。マージでは三ファイルに四箇所の衝突が出ましたが、多くは両側がそれぞれフィールドを足したもので、両方残せば済みます。マージ後にもう一度フルで走らせて、ユニットテスト 516 本、カバレッジ 90.3%、E2E 56 ケースが全部通りました。
三つめは、リリース前の品質レポートです。/pdlc-quality が見るのは四項目。カバレッジ、E2E のコアフロー網羅、lint、そして PRD とコアフロー一覧の突き合わせです。一回目のレポートは前三項目が緑で、四つめで止まりました。新しい三機能の受け入れ項目 19 件が、一件もコアフロー一覧に登録されていなかったのです。レポートの書き方は率直でした。45 本が全部緑でも、それは新しい三機能がゲートを通った意味にはならない、古い 45 本がまだ健全だという意味にしかならない、と。ループの中のサブエージェントは実際には各機能に E2E を書いていました。ただ、一覧に登録していなかっただけです。
対処は署名して通すことではなく、埋めることです。19 件を一覧に入れ、うち 4 件は既存のテストをそのまま参照し、残りには E2E を 9 本追加しました。二回目のレポートは四項目とも基準を満たし、コアフロー 64 本、65 ケースが実際に走って通っています。
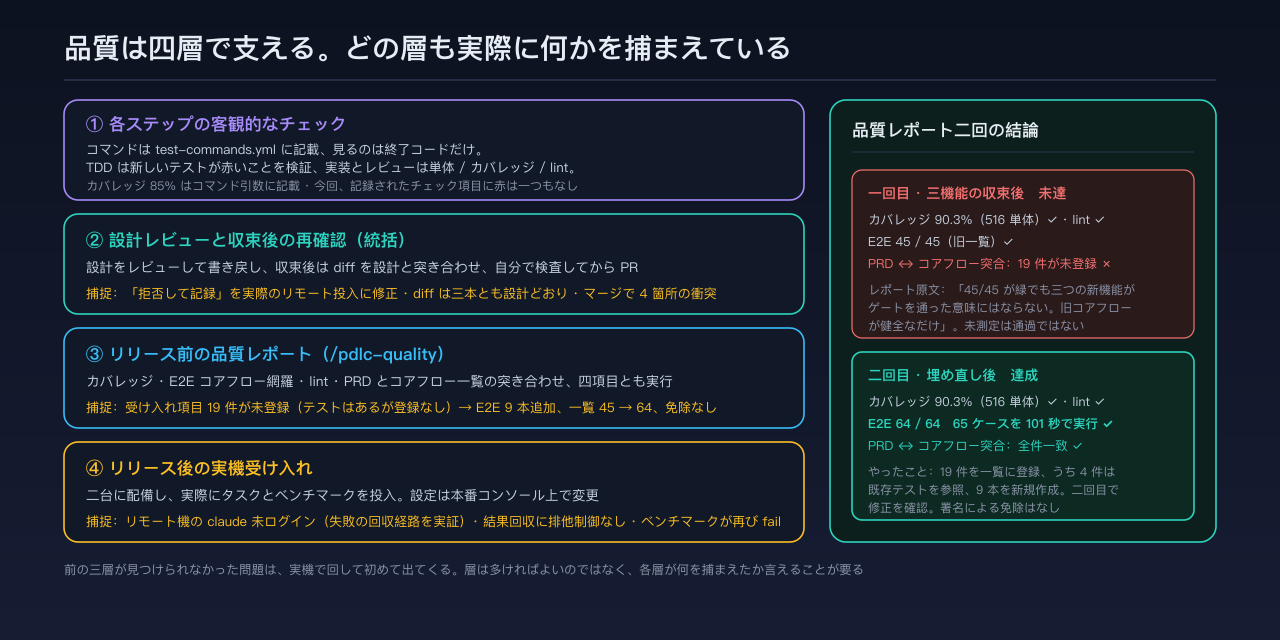
四つめは、リリース後の実機受け入れです。二台とも配備して、実際にタスクを投げて回しました。発生元フィルタは本番のコンソール上で設定し、受け入れとベンチマークの二つの発生元をミュート一覧に入れ、以降のタスクには発生元のタグが付いています。このフィルタの挙動は E2E で検証済みです。発生元が一致すれば完了通知は出さず、失敗の通知はそのまま出ます。
ノード間レビューも実際に一度通しました。レビュータスクを別のマシンに投入し、向こうで実行してアーカイブし、こちらが結果を回収して、どのマシンがレビューしたかをコンソールで確認できます。結果は失敗でした。そのマシンの claude コマンドが一度もログインされていなかったためです。この層が捕まえたのは環境の問題でしたが、「レビューが失敗したとき結果はどう戻ってくるか」という経路を実際に通せたことにはなります。受け入れではもう一つ、結果を回収するステップに排他制御がないことも見つかりました。二つのプロセスが同時に走ると、同じ結果を二回処理してしまいます。
ループが効かなくなるところ
ループが速く回ったのは、客観的なチェックがある場所です。遅くなったり間違えたりしたのは、記録が正確でない場所でした。
いちばんはっきりしているのは時間です。状態ファイルのタイムスタンプはモデル自身が書いています。振り返りのツールがそれを読んで計算すると、TDD 段階の中央値は 2.1 時間と出ます。一方、外側のスクリプトのポーリングが記録した実際の所要時間は、三つの TDD ステップでそれぞれ 10 分、21 分、13 分でした。先ほどの段階名の不揃いも、形を変えた同じ問題です。
なので外側の判断を、モデルが書いたフィールドの上に載せてはいけません。所要時間はイベントログと git のコミット時刻を基準にし、進捗は次ステップのフィールドか、プロセス終了時に出力される完了マーカーで見ます。この二点はそのまま、今回 pdlc-skills に戻したい改善でもあります。段階名を統一すること、タイムスタンプはコマンドから取ること。
シリーズはここまで
八回で、三層のモデルから始めて、導入、ループの回し方、品質の支え方、過程を見えるようにすること、そして最後に実際のプロジェクトを最初から最後まで通しました。話しているのは一つのことです。信用できない判断を、客観的なチェックのある場所に寄せる。そうすれば人は両端だけ、何を作るかと出すかどうかだけを押さえていればよくなります。
試してみる:
curl -fsSL https://raw.githubusercontent.com/kanfu-panda/pdlc-skills/main/install.sh | bash -s -- --global
リポジトリはこちら:https://github.com/kanfu-panda/pdlc-skills
役に立ったら star をいただけると励みになります ⭐
八回お付き合いいただきありがとうございました。実際のプロジェクトで似たことを回した方がいれば、どの工程がいちばん自分の時間を食いましたか。コメント欄で聞かせてください。
コメント