大規模言語モデルって、結局なに?
目次
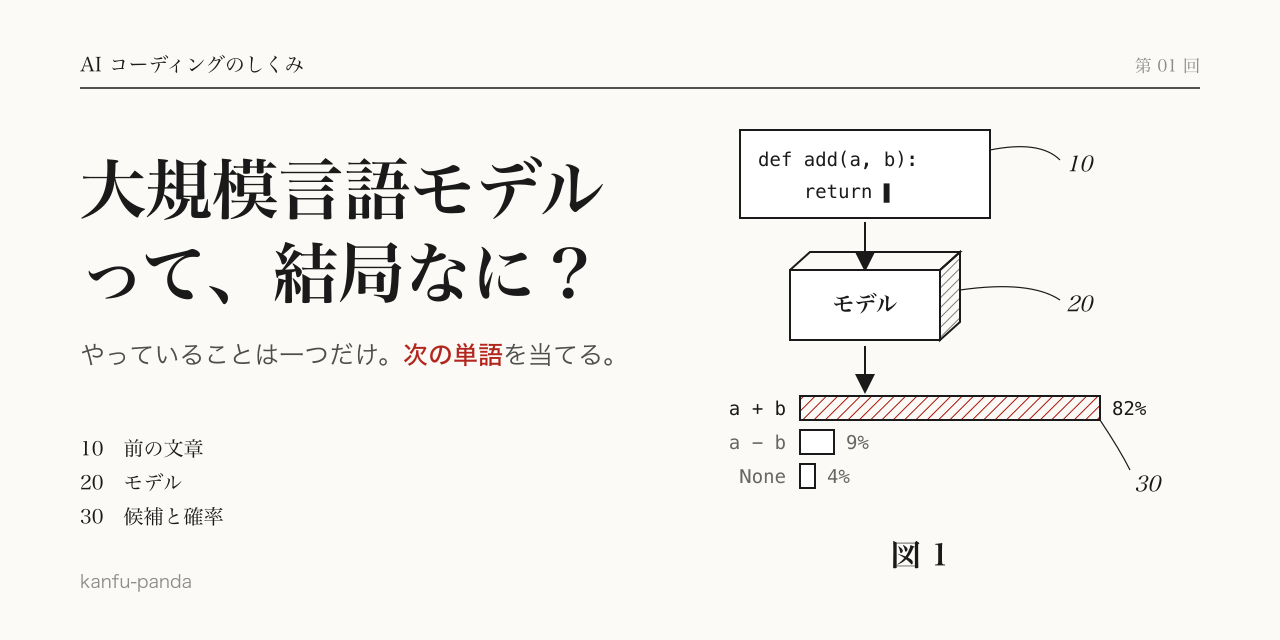
毎日 AI を使ってコードを書いていると、画面の向こうにいる「大規模言語モデル(LLM)」とはいったい何なのか、気になってきます。答えはシンプルで、次の単語を一つずつつなげていくプログラムです。それまでの文章を読み、次に来る可能性がいちばん高いものを選んでつなげ、また次を選ぶ。やっていることはそれだけですが、それでコードも書けるし、質問にも答えられるし、バグも直せます。この記事では Python の一行を例に、その仕組みを順番に見ていきます。
AI に何か質問すると、答えが一度にまとめて出てくるのではなく、少しずつ流れるように表示されることに気づいたことがあると思います。コードも一行ずつ伸びていきます。画面の演出のようにも見えますが、実はこれが大規模言語モデルの働き方そのものです。少し書いたら、また次の少しを書く。
なぜそんな書き方をするのでしょうか。まずは、一歩ごとに何をしているのかを見てみましょう。
一歩ごとに何をしているのか
書きかけの Python を見てみます。カーソルは return のすぐ後ろにあります。
def add(a, b):
    return
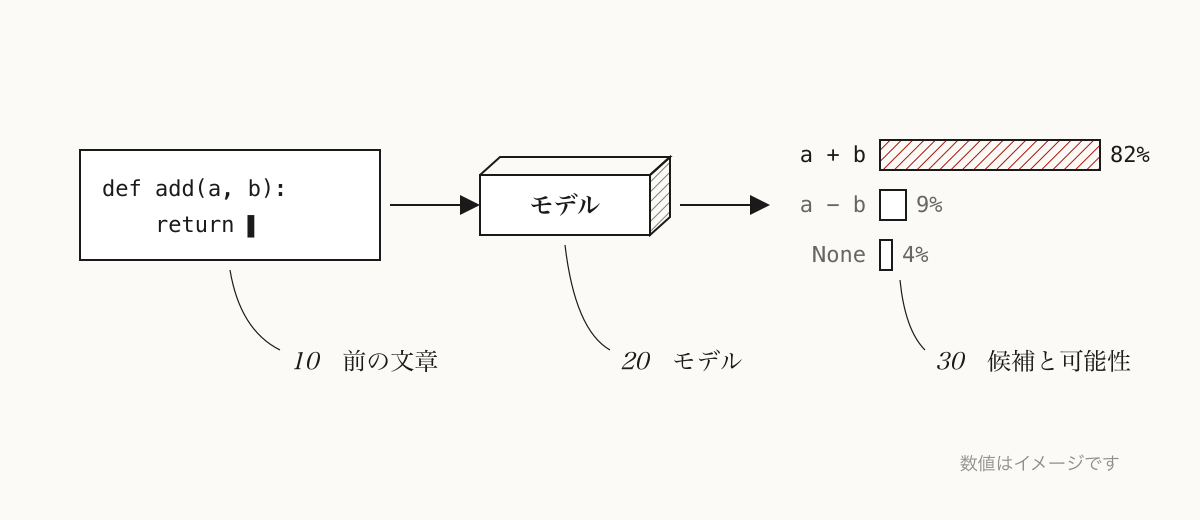
次に何を書くでしょうか。コードを書く人なら、ほとんど考えずに a + b と答えるはずです。関数名は add、引数は a と b ですから、a + b がいちばん自然です。
大規模言語モデルがやっていることも同じです。カーソルより前の文章をすべて読み込み、続きの候補それぞれに点数をつけます。a + b は高く、a - b は低め、None はさらに低い。その中から一つを選んでつなげます。
Anthropic の公式用語集にも同じことが書かれています。Claude の土台になっているモデルは、前の文章をもとに次の単語を予測するように訓練されている、というものです。
一つの単語が、どうやってコード全体になるのか
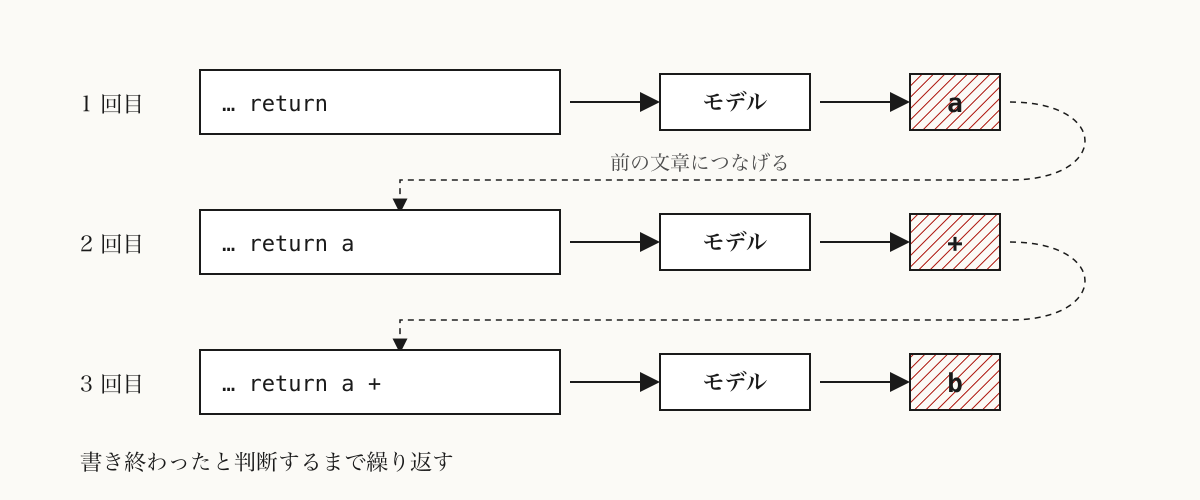
一語だけでは、まだコードにはなりません。そこで繰り返しを使います。予測した単語を文章の後ろにつなげ、少し長くなった文章で、また次を予測するのです。
a をつなげると、文章は return a で終わります。次にいちばん来そうなのは + です。+ をつなげれば、次は b。そのあと、関数はもう書き終わったと判断して止まります。コード全体も、長い回答も、こうして一語ずつつなげてできています。冒頭で見た「少しずつ表示される」様子は、この繰り返しが一歩ずつ進んでいる姿です。
厳密には、一回につなげるのは完全な単語とは限りません。単語の一部のこともあれば、記号一つのこともあります。この単位はトークンと呼ばれます。この記事では、わかりやすさを優先して「単語」と呼ぶことにします。
次の単語を当てるだけで、なぜコードが書けるのか
ここまで読んで、スマホの予測変換と同じでは、と思った人もいるかもしれません。
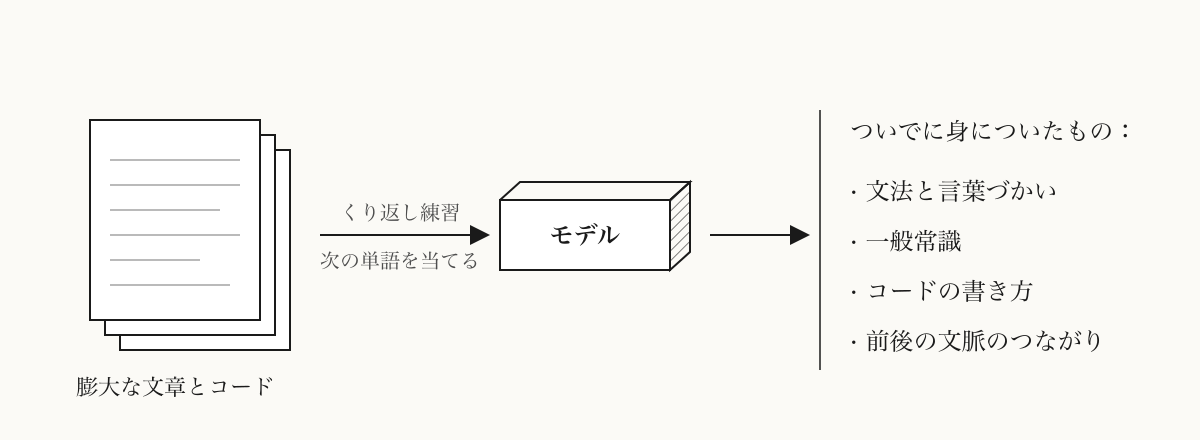
違いは、どれだけ正確に当てる必要があるかです。return のあとに a + b と当てるには、add が「足す」という意味だと知っていて、Python の関数の書き方もわかっていなければなりません。コードが長くなれば、前で定義した変数や、それぞれの関数が何をするのかも覚えておく必要があります。
大規模言語モデルは、訓練の段階で膨大な文章とコードを読んでいます。次の単語を正確に当てようとすると、文法や一般常識、コードの書き方といった規則性も一緒に身につけるしかありません。米ジョージタウン大学の研究機関 CSET も、解説記事で同じように説明しています。次の単語の予測という一見単純な作業が、言語全体への理解につながり、その理解はほかの多くの作業にも生かせる、というのです。
もう一つ、意外な話があります。モデルは、必ずしも一歩先だけを見て書いているわけではありません。Anthropic は 2025 年に、Claude の内部で何が起きているのかを調べた研究を発表していて、そこに二つの発見があります。
一つ目は詩です。研究者は、韻を踏む英語の二行詩を書かせました。一行目は “He saw a carrot and had to grab it”。一語ずつ予測しているだけなら、韻を踏む単語を探すのは二行目の最後になるはずです。ところが実際には、二行目を書き始める前から締めくくりを rabbit にすると決めていて、そこに向かって一行を組み立てていました。できあがったのは “His hunger was like a starving rabbit” です。
二つ目は足し算です。36 足す 59 はいくつかと聞くと、95 と答えます。どう計算したのかと聞くと、小学校で習ったやり方、つまり一の位を足して繰り上げる方法を説明します。ところが研究者が内部の計算を調べると、実際には二つの道筋を同時に使っていました。一つは答えのおおよその大きさを見積もり、もう一つは一の位を正確に求めます。モデル自身は、自分がそう計算していることを知りません。
二つの例を合わせると、こう言えます。一語ずつ書くのは外から見たときの働き方で、正確に当てるために、内部では独自のやり方を身につけている。そのやり方は誰かが一行ずつ書き込んだものではありません。訓練の中でモデル自身が身につけたもので、作った会社でさえ専用の研究をしなければ見えないのです。
なぜ指示に従い、アシスタントのように振る舞えるのか
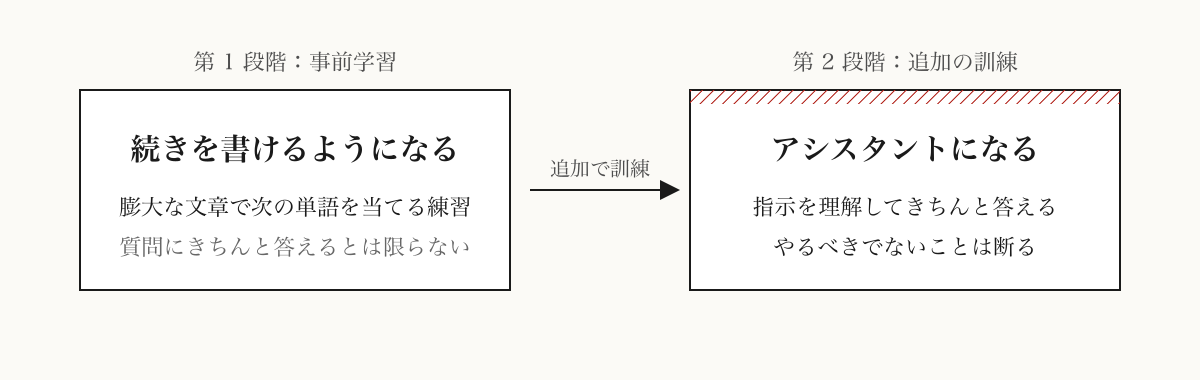
ここまで見てきた、膨大な文章を読んで次の単語を当てる練習をする訓練を「事前学習」と呼びます。事前学習だけを終えたモデルは、文章の続きを書くのは得意でも、質問に答えたり指示に従ったりするのはあまり得意ではありません。Anthropic の用語集にも、はっきりそう書かれています。
そこで事前学習のあとに、アシスタントとしての訓練をもう一段階行います。頼まれたことを理解し、きちんと答え、やるべきでないことは断る。私たちがふだん使っている Claude は、この訓練を経ています。用語集の言葉を借りれば、Claude は「素の」言語モデルではなく、役に立つアシスタントになるよう訓練されたモデルです。
この訓練の中身は話すことが多いので、次回でくわしく取り上げます。
AI でコードを書くとき、何に役立つのか
モデルが「続きを書いている」とわかると、すぐに使えることが二つあります。
一つ目。あなたが渡すものは、すべてモデルにとっての「前の文章」です。質問も、貼りつけたコードも、プロジェクトの説明ファイルも、すべて読み込んだうえで続きを書きます。前の文章が明確なほど、正しくつなげやすくなります。同じ依頼でも、「関数を書いて」と「Python で add という関数を書いて。整数を二つ受け取って、その和を返す」とでは、後者のほうがモデルが推測しなければならない部分がずっと少なくなります。
二つ目。モデルが書くのは「ここに来る可能性がいちばん高いもの」で、どこかで確かめてきた内容ではありません。たいていは、いちばんありそうなものが正解です。ただ、ときどき、もっともらしく見えて実在しない関数名や引数が出てきます。書かれたコードは、一度動かして目を通してから使いましょう。
Codex や DeepSeek でも同じなのか
同じです。Codex は OpenAI のモデルで、DeepSeek は DeepSeek 社が自ら訓練したモデルで動いています。どれも大規模言語モデルで、前の文章をもとに一語ずつ続きを書いています。違うのは、訓練で何を読んだか、そのあとどうアシスタントとして訓練されたか、そして周りのツールが代わりに何をしてくれるかです。上の二つの使い方は、どのツールでもそのまま通用します。
まとめ
- 大規模言語モデルは、次の単語をつなげていくプログラム。前の文章を読み、いちばんありそうなものをつなげ、また次を予測する。
- 正確に当てるために、訓練の中で文法や常識、コードの書き方を身につけ、先を見越して書くこともある。
- 渡したものはすべて前の文章になるので、明確に書くほど正確につながる。書かれたコードは確かめてから使う。
次回:続きを書くことしかできないモデルが、どうやってコードを手伝うアシスタントになるのか。
AI のことが少しでも身近に感じられたら、いいねやシェアで応援してもらえるとうれしいです。続きも読みたい方は、ぜひフォローしてください。
コメント