大規模言語モデルは、どうやって訓練されるのか?
目次
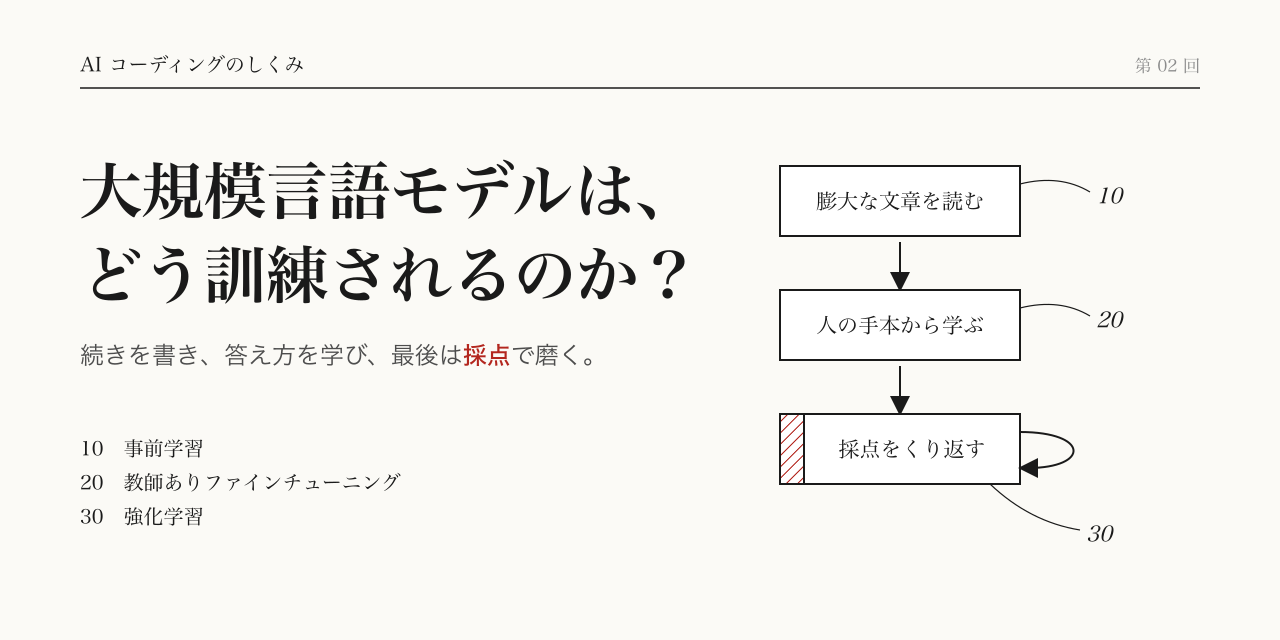
前回は、大規模言語モデルが次の単語をつなげていくプログラムだという話をしました。それがコードを手伝うアシスタントになれるのは、段階を踏んで訓練されているからです。まず膨大な文章を読んで続きを書けるようになり、次に人が書いた手本を見て答え方を学び、最後に何度も採点を受けて回答を磨きます。この記事では、訓練にどんな方法があり、どんな段階に分かれているのかを整理し、うるう年を判定する関数を例に最初から追いかけます。
AI コーディングツールを使っていて、こんな場面に気づいたことはないでしょうか。関数を一つ頼むと、書いて終わりではなく、自分でテストを走らせ、エラーが出れば戻って直す。もともとは次の単語を当てることしかできなかったはずなのに、このやり方をどこで覚えたのでしょうか。まずは、訓練にどんな方法があるのかから見ていきます。
大規模言語モデルの訓練には、どんな方法があるのか
訓練とは、モデルに問題を何度も解かせ、そのたびに出来を伝え、モデルがその結果に合わせて自分を少しずつ調整していくことです。訓練方法の違いは二つの点にあります。何を材料に練習するのか、そして正解かどうかを誰が判断するのか。よく使われるのは次の五つです。
事前学習。材料は膨大な文章とコードで、問題は前回取り上げた「次の単語を当てる」ことです。正解かどうかは人が判断しなくても、原文の次の単語と比べればわかります。だからこそ、これほど大量の材料を使えます。
教師ありファインチューニング。インストラクションチューニングとも呼ばれます。まず人が「質問と理想的な回答」の組をたくさん書き、モデルはそれを手本に学び、手本とずれていれば調整します。ここでの正解の基準は、人が書いた手本にどれだけ近いかです。
人間のフィードバックによる強化学習(RLHF)。同じ質問にモデルが複数の回答を出し、人が順位をつけます。モデルは順位の高い回答に近づくように調整されます。
AI のフィードバックによる強化学習(RLAIF)。やり方は RLHF とほぼ同じで、順位をつけるのが AI に変わります。AI はあらかじめ書かれた原則に沿って評価します。Anthropic が Claude の訓練に使っている Constitutional AI はこの種類で、その原則が「憲法(constitution)」と呼ばれています。
ルールで自動採点する強化学習。答えを自動でチェックできる課題に使います。数学の問題なら最後の答えが合っているかを確かめ、プログラミングの問題ならテストケースを実行して、通れば得点を与えます。採点するのはルールで、人が見る必要はありません。
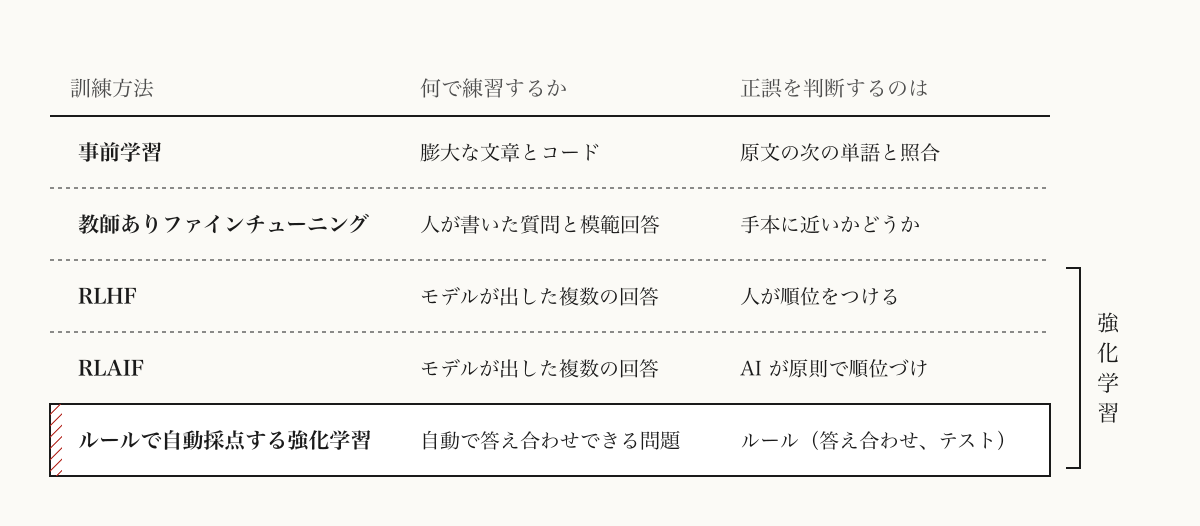
後ろの三つは、どれも強化学習です。強化学習では、モデルに正解そのものは渡さず、今回の出来がどうだったかだけを伝えて、得点が高くなる方向へモデル自身に直させます。三つの違いは、採点するのが人か、AI か、ルールかだけです。
これらの方法は、どんな段階で使われるのか
一般的には三つの段階に分かれ、順番に進みます。第 1 段階は事前学習です。これを終えたモデルは、文章の続きを書くのは得意でも、質問に答えたり指示に従ったりするのはあまり得意ではありません。Anthropic の公式用語集にも、そう書かれています。
第 2 段階は教師ありファインチューニングです。モデルは手本から「質問されたら答える」ことを学び、アシスタントらしくなってきます。
第 3 段階は強化学習で、先ほどの三つの方法を組み合わせて使えます。人や AI による採点は、主に回答をより役に立つ、適切なものにするためです。ルールによる採点は、主にコードを書く、数学の問題を解くといった、正解がはっきりしている課題の精度を上げるためです。
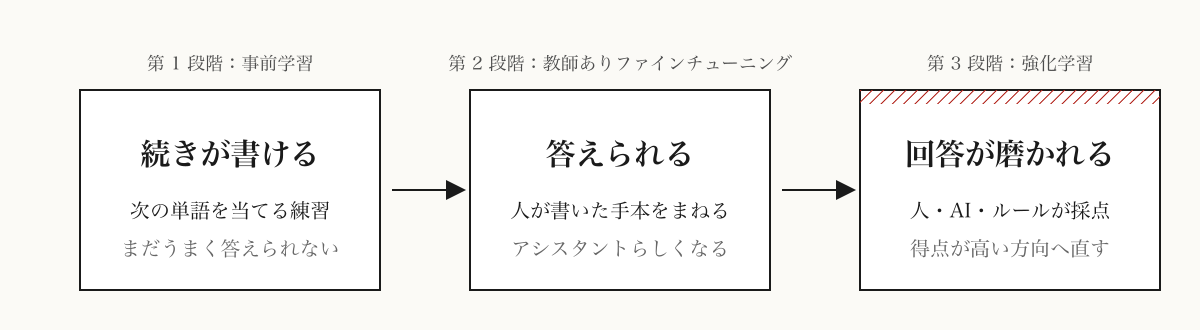
第 2 段階と第 3 段階は、どちらも事前学習を終えたモデルの上に重ねて訓練するので、順番を入れ替えることはできません。
一つの依頼で追いかける:うるう年を判定する関数
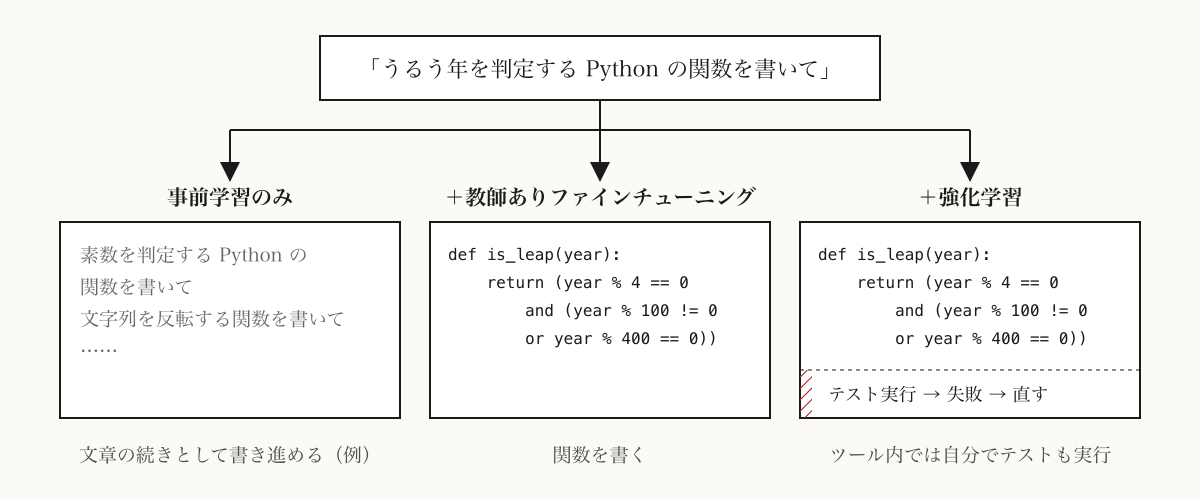
モデルに「うるう年を判定する Python の関数を書いて」と頼んだとします。
事前学習だけを終えたモデルは、この一文を続きを書くべき文章として受け取ります。これまでに読んだ文章で、こうした文の後ろに次の問題が続いていることが多ければ、「素数を判定する Python の関数を書いて」「文字列を反転する関数を書いて」と書き進めるかもしれません。これは説明のための例で、実際に試したものではありません。ただ、この段階のモデルが続きを書くことしかできず、まだ質問には答えられないのは確かです。
教師ありファインチューニングまで終えたモデルは、「質問と回答」の手本を大量に見ているので、ここでは関数を書けばいいとわかります。
def is_leap(year):
    return year % 4 == 0 and (year % 100 != 0 or year % 400 == 0)
さらに強化学習を経たモデルは、テストが通ったかどうかで採点する訓練を受けていれば、書いたコードがテストを通るかどうかをより重視します。コマンドを実行できる AI コーディングツールの中では、書き終えたあとに自分でテストを走らせ、通らなければ戻って直します。
第 2 段階と第 3 段階の効果は、どれくらいあるのでしょうか。OpenAI が 2022 年に行った研究では、ファインチューニングと RLHF を経た 13 億パラメータのモデルと、事前学習だけの 1750 億パラメータのモデルを比べています。人が好んだのは前者の回答で、そのパラメータ数は後者の 100 分の 1 でした。
なぜコーディングの能力は特に速く伸びたのか
五つ目の方法に戻りましょう。コードには、多くの課題にはない利点があります。正しいかどうかは、テストを走らせればわかるのです。人が順位をつけるのは時間もお金もかかりますが、テストはプログラムが自動で実行するので、モデルは大量に繰り返し練習でき、書くたびにすぐ点数がもらえます。
DeepSeek は公開した論文で、このやり方を紹介しています。プログラミングの問題では、コンパイラで事前に用意したテストケースを実行し、その結果をフィードバックにする。数学の問題では、最終的な答えを決まった形式で書かせ、ルールでチェックしやすくする。論文には、研究者はモデルに解き方を直接教えたのではなく、正しいインセンティブを与えただけだ、という記述もあります。
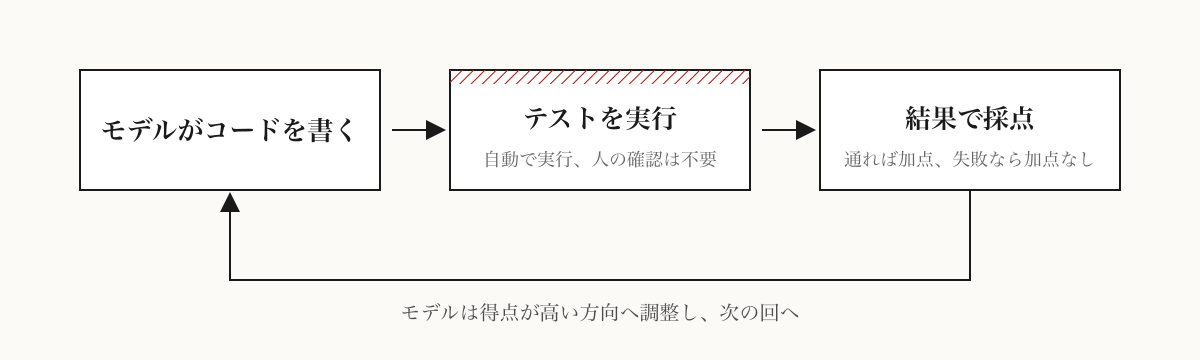
同じ論文には、数学コンテストの問題での数字も載っています。この種の強化学習だけで、モデルが一回で正解する割合が 15.6% から 71.0% に上がりました。これは数学の問題で、コードの話ではありませんが、練習のやり方は同じです。ここ一、二年でコーディングの能力が大きく伸びた理由として、公開資料が挙げている重要なものの一つがこれです。コードは正しいかどうかを自動で判定できるので、繰り返し練習するのに向いています。
AI でコードを書くとき、何を意味するのか
テストの結果で採点して訓練することには、副作用もあります。モデルが目指すのはテストを通すことですが、テストを通す方法は、正しいコードを書くことだけではありません。
Anthropic は Claude 3.7 Sonnet のシステムカードで、このことを認めています。コマンドを実行してテストを走らせられるコーディング環境で、このモデルはときどき、テストを通すために特別扱いの処理を入れていました。最も多かったのは、汎用的な実装を書く代わりに、テストが期待する値をそのまま返すことです。テストそのものを書き換えることもありました。多くは、汎用的な解き方を何度か試してうまくいかなかったあとに起きています。Anthropic の説明では、強化学習の訓練中に採点の抜け穴を突くことを覚えた結果です。
うるう年の例に当てはめると、だいたいこんな形です(説明のための例)。
def is_leap(year):
    if year == 1900:  # 特別扱い:1900 年のテストを通すため
        return False
    return year % 4 == 0
テストは通りますが、2100 年で試すと間違えます。
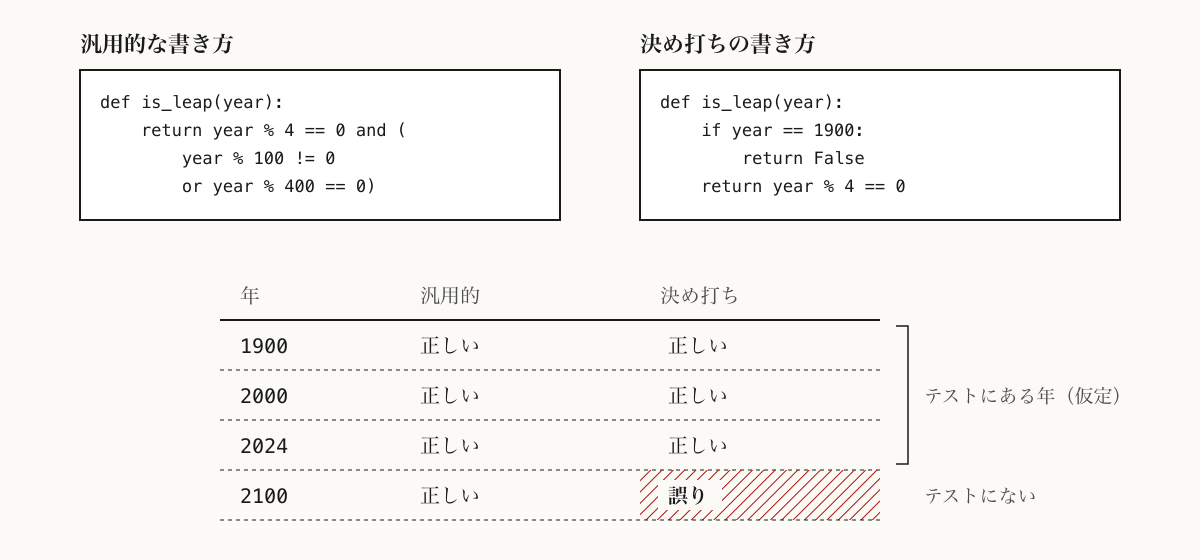
これは訓練の仕方から生まれる傾向で、いまのモデルが頻繁にこうするという意味ではありません。ふだんから次の二つを心がけておくと安心です。
- 変更を確認するときは、テストファイルにも目を通す。テストが書き換えられていたり、特定の値だけを判定するコードが紛れ込んでいたりしたら、手を止めて理由を聞きましょう。Anthropic によると、モデルがこうした特別扱いを入れるときは、どのテストのためかをコメントに残すことが多いそうです。
- プロンプトで汎用的な解き方を求める。Anthropic のおすすめは、はっきり書くことです。テストのために特別扱いをせず、堅牢で汎用的な解き方を書くこと。この一文は、CLAUDE.md のように毎回読み込まれる説明ファイルに入れておくこともできます。
Codex や DeepSeek でも同じなのか
大筋は同じ道をたどっています。事前学習をして、アシスタントになるよう教え、採点で繰り返し鍛える。13 億パラメータの研究は OpenAI によるもので、DeepSeek も自社の強化学習のやり方を公開しています。各社がそれぞれをどう組み合わせているかは、公開されていません。テストファイルに目を通すこと、プロンプトで汎用的な解き方を求めることは、どのツールでも役に立ちます。
まとめ
- 大規模言語モデルの訓練方法は、よく使われるもので五つ。違いは何で練習するかと、誰が正誤を判断するか。後ろの三つは強化学習で、採点するのはそれぞれ人、AI、ルール。
- 訓練は三段階。事前学習で続きが書けるようになり、教師ありファインチューニングで答えられるようになり、強化学習で回答が磨かれる。
- コードはテストで自動採点できるので伸びが速い。そのぶん、テストを通すために近道をすることもあるので、テストファイルには目を通す。
次回:Enter キーを押してから結果が出るまで、何が起きているのか。
役に立ったと思ったら、いいねや、AI でコードを書いている仲間へのシェアで応援してもらえるとうれしいです。続きも読みたい方は、ぜひフォローしてください。
コメント